
Percepción
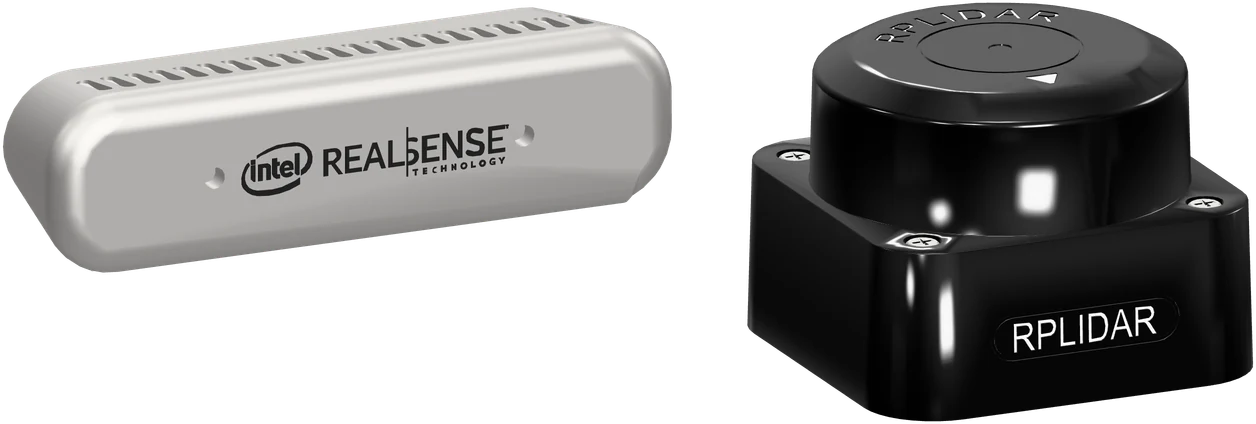
La percepción es lo que la NUC hace con sus dos sensores: un mapa 2D del entorno con el LiDAR, y video y visión por computadora con la cámara RGB-D. El resultado viaja al visor por ZeroMQ.
Sinopsis
Sección titulada «Sinopsis»Dos pipelines independientes dentro del coordinador de la NUC, uno por sensor.
| Parámetro | Valor | Unidad | Notas |
|---|---|---|---|
| RPLiDAR C1 | COM3 | 460 800 baud | Grid de ocupación 2D, paredes, puntos |
| Intel RealSense D435i | USB3 | — | Video RGB al XR, profundidad calibrada, visión |
Las características de cada sensor y cómo probarlo desde una PC están en su página: RPLiDAR C1 y RealSense D435i.
Archivos
Archivo
Coordinador de la NUC — nuc_master_code.pyCómo funciona
Sección titulada «Cómo funciona»Cada pipeline trabaja solo cuando el operador tiene abierto el modo que lo usa. El grid del LiDAR alimenta los paneles 2D del visor; las paredes y los puntos alimentan la escena 3D; el video y la visión, el panel central.
La profundidad nunca sale en crudo: antes se corrige con una curva de calibración, y la de cada detección se promedia en un disco de píxeles en lugar de leerse de uno solo.
Conexiones
Sección titulada «Conexiones» NUCpipelines de percepción
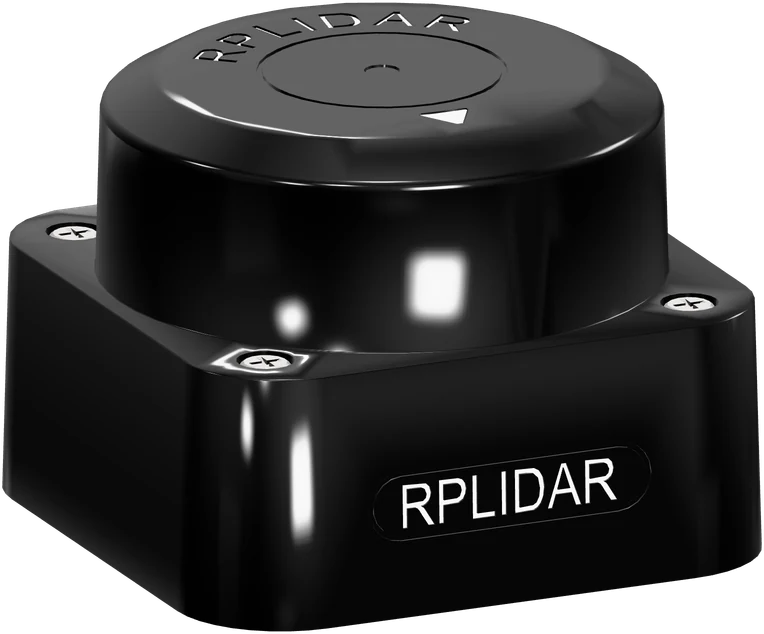 RPLiDAR C1LiDAR 2D
- COM3 · 460 800 baudRPLiDAR C1 → NUC: barridos 2D
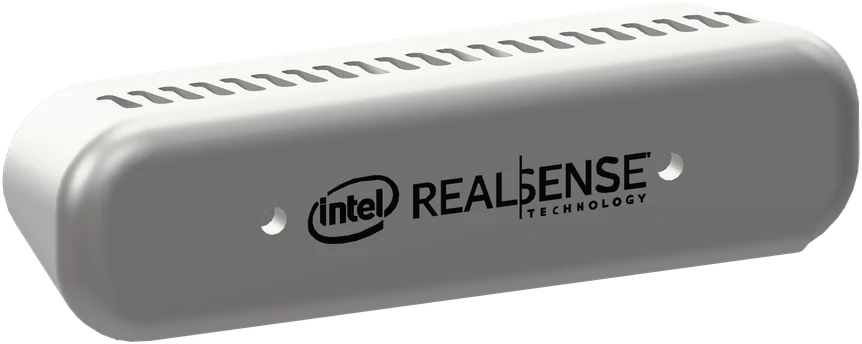 RealSense D435icámara RGB-D
- USB 3RealSense D435i → NUC: RGB 640 × 480 · profundidad
 Meta Quest 3paneles y escena 3D
- ZMQ por WiFiNUC → Meta Quest 3: 5555 video · 5001 grid y visión · 5007 paredes y puntos
RPLiDAR C1
Sección titulada «RPLiDAR C1»Grid de ocupación
Sección titulada «Grid de ocupación»El grid tiene tres modos, con celda fija de 1 cm en todos ellos. Lo que cambia entre modos es el radio cubierto:
| Modo | Radio | Grid | Frecuencia |
|---|---|---|---|
detail | 1 m | 200×200 | ~12 Hz |
medium | 2 m | 400×400 | ~12 Hz |
panorama | 3 m | 600×600 | ~12 Hz |
El grid se publica como JSON en el tópico lidar_grid. Los puntos con más
de 0,35 s de antigüedad se descartan antes de construirlo.
Modo paredes
Sección titulada «Modo paredes»Inmersivo y opcional (walls_enabled): alimenta la escena 3D del headset,
no los paneles 2D. El sistema acumula hasta 150 000 puntos en una ventana de
4 s y procesa el lote a ~1 Hz, en cinco etapas:
- Proyectar los puntos a un grid 2D de 10 cm, con 0,5 m de margen.
- Morfología para cerrar huecos y quitar ruido: dilatación (kernel 3, 1 pasada), cierre (kernel 5, 2 pasadas) y apertura (kernel 2, 1 pasada).
- Componentes conectados, descartando los de menos de 80 px de área.
- Simplificar las polilíneas con épsilon de 4 px, descartando las de menos de 8 px de longitud.
- Fusionar segmentos: se unen los que difieren menos de 15°, con ajuste a 3 px y extensión máxima de 4 px, y se alinean a la ortogonal con la misma tolerancia de 15°.
El orden importa. Cerrar antes de abrir une los tramos de una misma pared que el LiDAR ve con huecos, y solo después se elimina el ruido suelto; al revés, la apertura borraría puntos que el cierre necesitaba.
La salida son segmentos de pared compactos. Viajan en binario por el puerto
5007, con los identificadores WSNP para el snapshot completo y WDEL para
los deltas.
Modo puntos
Sección titulada «Modo puntos»También inmersivo (points_enabled). Publica hasta 12 000 puntos crudos por
paquete a ~8 Hz, por el puerto 5007, con los identificadores LPSN y LPFR.
RealSense D435i
Sección titulada «RealSense D435i»La cámara entrega un stream RGB de 640×480 a un máximo de 30 fps,
comprimido en JPEG con calidad 85. Se publica en el tópico video_rgb, por
el puerto 5555.
La profundidad se corrige con una curva de calibración interpolada entre 160 mm y 1000 mm.
Visión por computadora
Sección titulada «Visión por computadora»Corre en CPU, no en GPU, y cada modo carga un modelo distinto. Los dos no son de la misma familia, cosa fácil de pasar por alto al montar el entorno:
| Modo | Modelo | Salida |
|---|---|---|
pose | yolov8n-pose.pt | Keypoints de pose corporal |
segment | yolo26n-seg.pt | Máscaras de segmentación |
| Parámetro | Valor | Unidad | Notas |
|---|---|---|---|
| Dispositivo | CPU | — | La NUC no lleva GPU dedicada |
| Tamaño de entrada | 640 | px | |
| Umbral de confianza | 0,70 | — | Detección descartada por debajo |
| Umbral por keypoint (pose) | 0,20 | — | |
| Máscara mínima (segmentación) | 200 | px | Descarta manchas sueltas |
| Radio de muestreo de profundidad | 10 | px | Promedia un disco, no un píxel suelto |
| Profundidad máxima válida | 2500 | mm | |
| Frecuencia de publicación | 10 | Hz |
La profundidad de una detección no se lee del píxel central sino de un disco de 10 px alrededor: un solo píxel de la RealSense puede venir sin dato o con ruido, y una lectura errónea ahí desplaza el objeto entero en la escena.